与「dua」相关的搜索结果
dua 贴吧
一个关键词就是一个贴吧,路径全站唯一。
用户
未找到
包含 dua 的内容

[开源学习资源] AI Engineering from Scratch
59.8K ⭐️ 作者 @ghumare64 课程共 20 个阶段,以 Python 为主要编程语言,主张在导入任何框架之前,先用纯数学把每个算法手写一遍。
课程地址:
开源地址:
它和常见教程的本质区别 ?
大多数 AI 教程是“API 驱动”的:装个库、调个接口、跑个 demo。这个项目反其道而行,每节课遵循固定的六段结构:
Motto → Problem → Concept → Build It → Use It → Ship It
以 Phase 10 的一节课「Tokenizers: BPE, WordPiece, SentencePiece」 为例,这个格式是真实落地的,而且写作质量相当高:
· Problem 部分不讲废话,直接从代价切入:“你的 LLM 不读英语,它读整数。分词器决定这些整数是承载意义还是浪费意义”,然后解释为什么 tokenization 不是预处理,它是架构的一部分(影响上下文窗口利用率、API 计费、推理速度)。
· Concept 部分用“三种失败的方案和一种胜出的方案”来讲演化逻辑:词级切分(词表爆炸、[UNK] 问题)→ 字符级切分(序列过长)→ 子词切分(BPE 的折中),并配上真实语料上 BPE 逐步合并的手工演算。
每节约 3000+ 词,带 Mermaid 图、可运行代码和测试。
另外两个设计值得强调:
· 每节课产出一个可复用的 artifact,一个 prompt、一个 skill、一个 agent 或一个 MCP server。学完整个课程,你手里有 523 个可展示的作品,不是 523 个跑完就扔的 notebook。
· 强调“证据留存”:保留命令、退出码、输出,作为学习发生的证明。这明显吸收了工程实践中“可验证性”的思路。
# 课程结构:从线性代数到自主智能体集群
20 个阶段构成一条完整的上升曲线,咱们它分成五个大块来看:
基础层(Phase 0–2):环境与工具链、数学基础(线性代数/概率/微积分)、经典机器学习。这是给基础不牢的读者铺的路。
深度学习与感知层(Phase 3–6):神经网络核心、计算机视觉(一路讲到 NeRF、高斯泼溅、世界模型,这已经超出一般教程的覆盖范围)、NLP、语音。
生成与决策层(Phase 7–9):Transformer 深挖、生成式 AI(GAN、扩散模型、flow matching)、强化学习。
LLM 层(Phase 10–12):这是全课程的重心之一。Phase 10 的目录我逐条看过,它不只是“从零实现 GPT”这种常规内容,还包含了相当前沿的论文级主题:DeepSeek-V3 架构走读、DualPipe 并行策略、Native Sparse Attention(NSA)、多 token 预测、Jamba 的 SSM-Transformer 混合架构、 speculative decoding 等。Phase 11 转向应用侧(RAG、LoRA、MCP、可观测性),Phase 12 覆盖多模态(从 CLIP 到 computer-use agent)。
智能体层(Phase 13–16):工具与协议(MCP、A2A、Agent Skills)、54 节课的 agent 工程、自主系统与安全、多智能体集群。这一层的分量很能说明项目的判断:它认为 AI 工程的重心正在从“训模型”转向“构建可靠协作的智能体”。
收尾(Phase 17–19):生产基础设施、伦理与对齐、毕业设计。
# 生态与周边:不只是一个课程仓库
网站:带浏览器本地存储的学习进度追踪、术语表、课程目录和路线图。
六卷本书籍:课程内容由 CI(pandoc)自动构建成 EPUB/PDF,附在 GitHub Releases 上,课程即书,且随仓库持续更新。
Agent 导师模式:运行 npx skills add rohitg00/ai-engineering-from-scratch,可以把整个课程装进 Claude Code、Codex 等编码智能体,变成一个带分级测验(placement quiz)和个性化路径的交互式导师,学习进度写在 LEARNING.md 里。这是“用你正在学的工具来学”的巧妙闭环。
认证备考:5 条备考路径、67 节课、505 道练习题,覆盖 Anthropic 的 Claude 认证和 Agentic AI Foundation 的 MCPA。项目明确声明与这些考试机构无关联,只是独立的备考材料。
12 种语言的翻译(含中文),以及四条核心学习路径(构建与部署 AI 应用、软件工程基础、Agent 辅助工程、产品判断与交付)供不同目标的人选路。
显示更多

这个开源项目系统整理了 35 家 AI 公司的 AI 工程师面试题,全部来自 “公开报告的面试经历”
来自 @outcome_school 团队 @pallavishekhar_ 开源发布,内容几乎涵盖了 OpenAI、Anthropic、DeepMind、xAI、DeepSeek、Kimi、GLM 等 AI Labs,Cursor、Cognition、ElevenLabs 等 AI Native 团队和 Nvidia、Microsoft、Amazon、Apple 等头部大厂。
覆盖的岗位头衔也非常多:AI Engineer、LLM Engineer、Gen AI Engineer、ML Engineer、Research Engineer、Applied Scientist、FDE、MLOps/LLMOps 工程师等。
开源地址:
# 内容架构:一个精心设计的双层结构
第一层:跨公司通用题(Common Questions)。
作者把在多家公司反复出现的题目只列一次,标注"Asked at"哪些公司,按十大主题组织:
1. LLM 内部机制与架构 — attention 缩放因子、KV cache 内存公式推导、MQA/GQA/MLA、FlashAttention、BPE、RoPE/YaRN、Chinchilla scaling laws、MoE、解码采样策略、lost-in-the-middle、RMSNorm、SwiGLU
2. 推理、服务与 GPU 性能 — prefill vs decode、continuous batching、PagedAttention、投机解码、量化(FP16→FP4)、五种并行策略、TTFT/TPOT 指标、H100 上的 roofline 计算、vLLM/SGLang/TensorRT-LLM 选型、“如何把服务成本降 10 倍”
3. RAG 与检索 — 分块策略、BM25 vs 稠密检索、重排序器、HyDE、权限感知检索、ANN 索引、索引新鲜度、答案归因
4. Agent 与工具调用 — ReAct、MCP、工具 schema 设计、多智能体编排、Agent 记忆、循环终止条件、人类审批
5. 微调与对齐 — RLHF/DPO/GRPO/RLVR 全谱系、LoRA/QLoRA 数学、灾难性遗忘、“提示 vs RAG vs 微调”决策框架、蒸馏、reward hacking
6. 评估与可观测性 — LLM-as-judge 及其偏差、幻觉检测、基准污染、Agent 评估、回归门禁
7. 安全与负责任 AI — 提示注入(直接/间接)、OWASP LLM Top 10、护栏、Constitutional AI、红队
8. 多模态与语音 — VLM、语音 Agent 延迟预算、barge-in 打断处理、级联 vs 端到端语音、ASR/TTS 评估
9. AI 系统设计 — 十类高频设计题(千万级文档企业 RAG、代码助手、客服 Agent、Text-to-SQL、LLM 网关、数亿用户聊天服务等)
10. 编码题 — 从零实现 attention、KV cache、BPE、采样;LRU 缓存、令牌桶限流器、异步批处理器、SSE 流解析器、最小 Agent 循环
第二层:35 家公司的专属章节,分为五大梯队:
1. 前沿实验室(12 家):Anthropic、OpenAI、Google DeepMind、Meta、xAI、Mistral、Cohere、DeepSeek、月之暗面(Kimi)、智谱(GLM)、阿里(Qwen)、Sarvam AI(印度)
2. 大厂 AI 组织:Microsoft、Amazon、Apple、NVIDIA、Tesla,以及一组消费级 ML 公司(Uber/Netflix/LinkedIn/Airbnb/Pinterest/Spotify)
3. AI 基础设施公司:Databricks、Groq、Together AI、Hugging Face、Scale AI、Perplexity
4. AI 原生产品公司:Cursor、Cognition(Devin)、Sierra、Harvey(法律)、Glean、 AI(机器人)、Waymo
5. 前向部署/企业 AI:Palantir
# 题目分布透露的行业信号同样值得关注
1. 公司的差异化考察方向,和它的商业模式严丝合缝。 这是最能体现整理功力的地方:
· DeepSeek、月之暗面、智谱、Qwen 的题目深度绑定自家论文——MLA、auxiliary-loss-free 负载均衡、Multi-Token Prediction、MuonClip、DualPipe、长上下文扩展、GLM 的 thinking 模式。面试这些公司等于面试它们的论文,还要求 PyTorch 从零实现 MoE 路由。
· Groq 的题全是 SRAM-only 架构下的 roofline 重推演:“没有 HBM,decode 的 roofline 论证哪里变了”、“确定性在 p99 层面到底买到什么”。
· Apple 清一色端侧:3B 模型在手机上跑、PTQ vs QAT、不采集用户内容的前提下用设备信号改进模型、30+ 语言区无法记录用户内容的评估方案。
· CharacterAI 是推理经济学:“我们的服务成本被 KV cache 而非权重主导,降一个数量级,代价是什么”。
· Harvey(法律)和 Abridge(医疗) 考的是领域约束下的工程:200 页信贷协议里第 140 页的条款依赖第 8 页的定义术语怎么检索、生成的病历中出现了患者没提过的药怎么当作安全事故处理、PHI 如何约束整个架构。
· Palantir 的招牌是 "decomposition" 轮:把“一家货运铁路公司每年因机车非计划停机损失数千万”分解成工程计划。
2. 编码轮的形态正在发生实质性变化。 文档里反复出现的一类题,与传统 LeetCode 明显不同:
· “实现一个内存 KV 存储:先 SET/GET/DELETE,再加事务 BEGIN/COMMIT/ROLLBACK,包括嵌套事务”(OpenAI、xAI 都问)
· “给你一个 LLM 推理引擎的调度器类,其中一个方法是空壳,没有规格没有文档。说说你头三十分钟干什么”(xAI)
“重构这 120 行能跑但很乱的代码,不许破坏测试”(OpenAI)
· “对 5 万个文档跑 LLM 调用,API 限 100 并发、偶发 429 和超时,把 Python 写出来”(Anthropic)
考察重心从算法记忆转向增量需求下的代码演进能力、并发正确性、真实工程约束下的取舍。
3. “AI 协作轮”作为新题型已经进入正式面试流程。 这是文档里最前沿的信号:
· Anthropic 部分机器学习岗有 AI-collaboration 轮:现场给你 Claude,考察的是你如何指挥它和验证它的产出,而不是你自己写。
· Meta 2026 年的流程新增三阶段 AI 辅助编码轮(探索修复 → 实现新功能 → 扩展改进)。
· Cursor 的 onsite 是两天在真实 Cursor 代码库上做一个功能(或 8 小时远程版),明确考核你对 AI 工具的使用效率和自主 scoping 能力。
· Sierra 给你两小时和任意 AI 工具,看你选择做什么。
xAI 有四小时限时产品构建。
4. FDE 成为一级岗位类别。 Anthropic、OpenAI、Databricks、Scale、Together、Sierra、Harvey、ElevenLabs、Palantir 的章节里都有 "Applied and Forward-Deployed Scenarios" 专属题库——典型题目如“企业客户说 Claude 幻觉太多,你是驻场工程师,头 48 小时做什么”。这对应了 AI 公司向企业交付方式的转变:模型能力差距收窄后,落地能力成为差异化。
5. 硬核系统题的普及。 "H100 上 70B 模型 batch size 1 的 roofline 计算"、"估算 70B 模型的 GPU 显存(权重 + KV cache + 激活 + 碎片)"、"p99 延迟在部署后翻倍但模型没变,走一遍诊断”——这类题横跨 NVIDIA、Together、OpenAI、Perplexity 等多家,说明推理性能的量化直觉已成为 AI 工程师的通用素养,而非基础设施工程师的专属。
显示更多


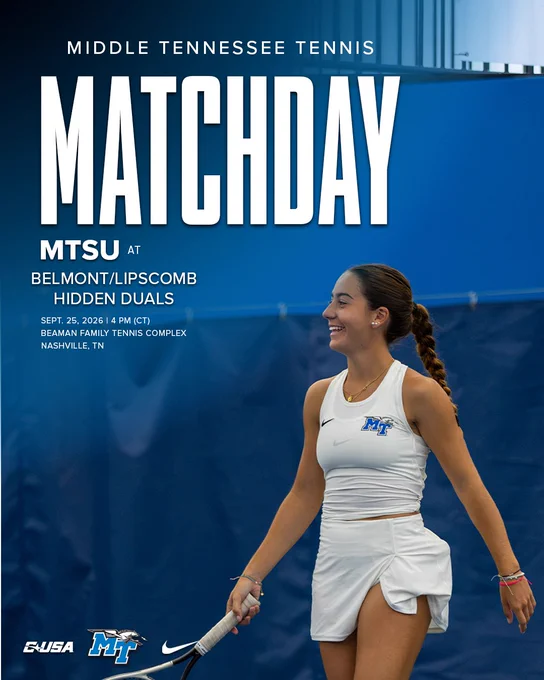
Some hidden duals on deck this weekend ⚔️

PlayStation® x LISA
「DualSense® ワイヤレスコントローラー “LISA” リミテッドエディション」が10月30日(金)発売!
音楽からファッション、そしてゲームへ。LISAならではの唯一無二なスタイルをまとったPlayStationの新たなコントローラーが登場。
詳しくはこちら⇒
显示更多

下午没啥事把苹果的 Apple Event 翻了一下,开场拍的挺好。产品也不错,不过没有换机的欲望。
iPhone 18 Pro 的背板貌似和 17 一毛一样。Dua 这个产品,目前还没有打动我的地方,暂时还没有折叠屏的念头。苹果表的自动记录有点意思,不过身边很多录音卡和麦克了,需要这个吗?
最后想了半天,还是喜欢 Mac。
显示更多


Just a reminder that Dua Lipa is unbelievable and beyond sexy


From Digital Twins to Data Engine: Cutting the Real-Data Burden with Sim-Powered Robot Learning
Teaching a robot a new task could take hundreds of teleoperated demonstrations. For foundation models, adapting to an entirely new robot can cost orders of magnitude more — dedicated hardware, trained operators, months of engineering.
On @boosterobotics' dual-arm robot, we studied this at two levels:
✱ Specialist: Can task-aligned simulation mixed with a small set of real demonstrations reduce the real-data burden?
✅ Yes. With only 10 real demos, the policy made no contact at all in physical rollouts (0/20). Adding 50 simulated trajectories brought contact to 17/20.
✱ Foundation: Can data accumulated across tasks build a reusable starting point (a Booster-specific model prior)?
✅ Yes. After full-parameter continued pretraining, a model adapted with just 30 demonstrations per task beat the original given twice as many: 14/16 vs 10/16 in simulated evaluation. Before any task-specific adaptation, in zero-shot simulation, it was already roughly 3× closer to the target (17.27 cm → 5.78 cm).
This work runs on Axis Suite, our Physical AI solution across different robot embodiments. Distributed contributors generate task-aligned sim data on Axis Hub at scale, reducing real-data needs for specialist adaptation while powering cross-embodiment generalist training.
Read the full blog:
显示更多


Last Call, Whales. The S7 Battle is almost over!
There are just over six days left to trade, climb the leaderboard, and claim your share of 11,700 USDT.
New to Dual Asset? Start with just 30 USDT and get a 100 USDT Trial Fund.
Trade now:
#NewFinancialPlatform#
显示更多


山西:推动煤炭产业产品实现“两个攀升”SHANXI DRIVING DUAL ASCENSIONS IN THE COAL INDUSTRY AND PRODUCT VALUE


Sometimes the duality between my own cosplays makes me giggle cus wdym these were filmed oN THE SAME DAY LMAOO
The bunnysuit will make a comeback someday ;w; just dunno when
#ResidentEvil# #ResidentEvilCosplay# #RebeccaChambers# #RebeccaChambersCosplay# #Capcom# #REBHFun#
显示更多
