与「指令」相关的搜索结果
指令 贴吧
一个关键词就是一个贴吧,路径全站唯一。
用户
未找到
包含 指令 的内容

最近 Almanak 上线了新产品,之前做过一些研究,所以正好借着热度,聊聊这个项目。
他们主打的口号是:一个人跑一个链上对冲基金。
查了一下 Almanak 这个词,是“年鉴”的意思,一般图书喜欢叫这个名字,例如《中国文物年鉴》。
不过这个项目做的东西是 AI 代理+策略,上面各种策略横飞,加到一起,倒是也可以称之为基金策略年鉴。
于是乎,测试了一下他们的产品,输入的指令是:
在 Uniswap 上做主流币(WBTC、ETH)+稳定币(USDT、USDC)做 LP。
1. 定位哪个 Pair 的 APR 最高,在什么链上?这可能会涉及到 2*2*链数 种可能。
2. 通过近期、中期判断应该设置的价格区间
3. 根据价格区间计算应当投入的主流币、稳定币两种本金占比(假设每个仓位投入 100K 美金)
然后 Almanak 的 AI 问了几个问题之后,就开始抓取、分析。
最后分析出来,Base 上面的 ETH/USDC 流动性是以上这些选择里 APR 最高的,然后选择了 1600-3300 区间。
接下来,就直接进入开发、测试、部署流程了。
PS:真不把 AI 当人啊。
整个流程也就 10 分钟。下一步,如果真的往里面打入 $ETH,这个钱包就会真的直接开始执行策略。
话说回来,从基金风控角度来说,大资金不应该直接放在 AI 写的代码里。大资金真用的话,可能还是得引入真人来校对、找专业的代码审计机构,来审计一下才能用。
这个 Almanak 产生的代码,适合小资金、适合测试想法,也就是“构想验证”。
例如去年年底,有个机构申请了夜盘比特币 ETF,在美股收盘后建仓比特币,白天天亮了就卖了。这种 idea 你乍一听挺好,但是具体效果如何,你还得去真跑一个测试。
你丢个 100 美金进去,直接告诉Almanak,让它 Vibe Coding 出来的代码一跑,跑个十天半个月的实盘,心里自然就有结果了,一下子节约好多时间。
这也是为什么拿嘴编程叫 Vibe Coding,因为它就是一种感觉(Vibe),靠感觉驱动的。
说回年鉴,因为都是 Vibe Coding 出来的策略,所以它还有个策略广场,里面有各种策略。例如在 Pancake 上跑的,BTC-BNB 策略,然后还有 AI 打分,评价了安全性和收益率等等。
感兴趣的话,可以都来测试一下。
每个普通用户可以白嫖三个策略(Signal),不过如果写得策略比较多,就要充值会员了。
链接在评论区。
显示更多


2026 年 9 月 29 日,OpenAI 在旧金山 Fort Mason 办了今年的开发者大会 DevDay。主讲是 CEO Sam Altman。其他几位上台的人都在做这些产品。产品团队的 Holly 演示了新产品 Dots。后训练(模型预训练之后做对齐和能力调优的阶段)研究负责人 Tejal 讲了模型怎么反过来帮 OpenAI 做研究。Codex 的演示由 Romain Huet 来做,他在 OpenAI 负责开发者体验,去年 DevDay 主题演讲里的 Codex 演示也是他做的。整场演讲分三块:面向用户的常驻智能体 Dots 和协作空间 ChatGPT Space,给开发者的新模型和新工具,以及帮开发者做分发、赚钱的渠道。
1. Dots:一直在线、会主动干活的智能体
Sam 把 Dots 比作电影里那种一直在身边帮忙的 AI 助手。他认为订餐厅、买机票这类代办虽然有用,但和这项技术能做的事比起来太小了。他想要的 AI 知道正在发生什么,也知道你在意什么,不用你事事交代。
Dots 是常驻在线的智能体(Agent),有自己的云端电脑和浏览器,能写代码、跑测试。它的权限跟着用户走,能直接用用户已经在 ChatGPT 里连好的插件,覆盖 4000 多个应用。除了在 ChatGPT 里对话,之后还可以给它发短信、打电话。目前每人先有一个 Dot,以后可以配一整组。Dots 跑在 本月早些时候发布的 GPT-6 Astra 上,Sam 称它是 OpenAI 对齐做得最好的模型。用户可以限定 Dot 能用哪些应用、能不能操作电脑,也能给它的各类操作写自定义指令,愿意交出多少责任就放多少权。
Sam 说,他自己的 Dot 每天早上会把夜里进来的消息过一遍,挑出紧急的提醒他。他说这让他拿回了一部分注意力,没那么离不开手机了。他还举了一个更重的例子:把应用从一个即将停用的旧 API 上迁走。这个 API 可能散落在代码库各处,改了哪里会连带弄坏什么,事先看不出来。Dot 可以追踪依赖关系,找出所有要改的地方,写代码、跑测试,最后把 PR(代码合并请求)交给团队审。他让听众想想,过去做这件事要几个人、花多久。
开场视频里,用户把自己的 Dot 改名叫 Alfred。Alfred 和另一个 Dot 帮用户上线网站,改董事会材料,在婚礼蛋糕商家取消后找好备选。它们还发现财务会和女儿的演出撞了期,提出改时间。每件事都是 Dot 推进到需要人确认的地方,再由人拍板。
2. ChatGPT Space:人和智能体一起用的工作区
Sam 认为,现有的生产力软件几乎都没考虑过人和 AI 一起干活。ChatGPT Space 以页面为单位,可以在里面写计划、做调研、生成图片和数据。页面和文件像网盘一样放在同一个空间里。Dot 能直接在页面上工作,在评论里 @ 它,它就会接活。页面本身也能带指令,比如“每天去看 API 平台的 Slack 频道,把发现更新到这里”。之后 Space 里还会加入演示文稿,格式做成智能体方便读写的样子,团队成员可以和各自的 Dot 一起改。
在 Holly 的演示里,页面用斜杠命令就能插入交互图表、表格和可运行的原型。她 @ 自己的 Dot(名叫 Dotty),让它把一组数据改成柱状图。图表可以按反馈类型筛选,Dotty 每小时刷新一次。她还让 Dotty 把“某位工程师在我 Slack 私信里提过的新手引导数据”补进 FAQ。Dotty 能看到她的上下文,所以这种模糊的指代也找得到。
3. OpenAI 内部怎么用 Dots
Holly 用一个虚构的歌单应用 Blossom Music,模拟发布前一天的状况。早上 Dotty 已经做了几件事:发现发布评审会提前,改好了日历;看完前一晚测试用户的反馈;注意到设计团队临时改了首页,把新设计发给她。她让 Dotty 直接把这个设计做出来。Dotty 调用她笔记本上的 Codex 构建应用,在 iPhone 模拟器里跑起来,再提交 PR。现场的语音演示卡住了,Dotty 一直回复“还在查”。Codex 线程也报过一次错,她重试后才继续下去。
她说,Dots 真正改变 OpenAI 工作方式的地方在 Slack。Dots 在公司 Slack 里有自己的身份,员工就开始把它们当作代理人。被同事 @ 到的零碎请求,直接转给自己的 Dot 处理。建群时,大家从一开始就把各自的 Dot 拉进来,Dot 带回结果时所有人都能看到。
工程师走得更远。有人在反馈频道贴出会话 ID 和一个用户 bug,某位工程师的 Dot 就会接手排查,提 PR 修复。她说这是真实情况:工程师们的 Dots 每天这样修掉几十个 bug,Dots 这个产品本身有很多部分就是 Dots 写的。
4. 上线范围和企业用的 Specialist Dots
Dots 和 Space 当天向 ChatGPT Pro、Business Premium 和 Enterprise 用户开放。Dot 包含在套餐里,和它的对话不占用额度。
企业客户还可以预览 Specialist Dots。这是由公司统一设置、供整个团队使用的虚拟同事,负责会计、市场、法务这类工作量大的事。公司给它目标和背景,审核它的产出,给它反馈,反馈在全公司共享。OpenAI 也在和微软合作,把 Specialist Dots 接入 Agent 365(微软用来管理企业智能体的工具),企业可以用已经在用的微软工具来管理它们。
5. 新模型:更便宜的 GPT-6.1 Sol,更快的 UltraFast
Astra 发布这几周,用户的要求集中在两点:更便宜,更快。GPT-6.1 Sol(转录稿误作 Soul)的能力接近 Astra,价格是它的五分之一。缓存输入(重复发送、已被缓存的上下文)比标准输入便宜 95%。智能体需要反复读同一批上下文、长时间迭代,这对它们尤其省钱。Sam 说 Sol 在某些方面比 Astra 还聪明,定位是开发者的日常主力模型。
UltraFast 是新的速度档,API、ChatGPT 和 Codex 里都能用。原有的 Fast 档是两倍速度、两倍价格;UltraFast 是八倍速度、六倍价格,每秒 300 个 Token。它现在可以配合 Astra 用,之后也会支持 Sol。现场让两个模型用同一个提示词,做一个 DevDay 配色的火箭。UltraFast 的火箭已经升空时,标准速度的还没做完。
订阅也跟着调整。新推出的 500 美元档 Pro 订阅叫 Pro 500,额度最高,是 Plus 的 25 倍。它可以在 ChatGPT 和 Codex 里用 UltraFast,还能通过“用 ChatGPT 登录”在合作方的应用里使用。Pro 200 重新开放,继续提供所有前沿模型。
另外预览了 Decisions API。它给 Luna 模型一组预先定义好的选项,让模型从中选一个,比如给请求分流、给图片分类、决定智能体下一步做什么。任务收窄成选择题之后,响应时间可以压到一秒以内,同时保留图像理解、多语言和安全防护。Romain 后来补充说,做机器人的朋友看中的是它能处理视觉输入:机器人可以根据看到的东西,近乎实时地快速行动。
6. 模型开始帮 OpenAI 做研究
Sam 提到,去年这个时候,他和 Jakob 在一次直播里预测,一年内会出现第一个“AI 研究实习生”,当时几乎没人相信。几周前 OpenAI 宣布达成了这个目标:有了一个能接手定义清晰的研究任务的系统,这类任务原本要熟练的研究员花大量时间和精力。
Tejal 的方向是电脑操作(computer use,让模型像人一样操作桌面和浏览器)。她举了两个例子。
第一个是让模型优化电脑操作的运行框架(harness,包在模型外面、负责调用工具和管理步骤的代码)。模型在循环里持续寻找能同时降低延迟、提升效果的改动,团队把找到的改进合进生产环境的框架,并用于后训练。结果是延迟改善了两倍以上,已经上线。
第二个是模型帮忙改进了监控和拒绝训练,让 Astra 在不安全的场景里更会拒绝。Astra 在电脑操作压力测试上因此达到业内领先,操作时出错更少,也更贴合用户的本意。
她给出了几项内部数据。今年夏天之后,研究工作消耗的 Token 量急剧上升。1 月时,模型能做好 15 分钟以内的短任务,需要一天以上的任务大多会失败;到 7 月,超过三分之一的一天量级研究任务,模型能在无人干预下完成。她还提到,Astra 这类模型已经帮忙解决了 100 多个悬而未决几十年的数学问题,也在参与针对耐药感染的新抗生素、古代语言研究、可再生能源和工业机器人等方向的工作。
7. 给开发者的底层工具
Sam 说,OpenAI 想让开发者用上自己内部用的东西。
第一件是 Codex 的运行框架。它同时支撑着 Codex、ChatGPT Work 和 Dots,目标是用最少的 Token、最快拿到准确结果,现在已经开源。第二件是 Codex 完全上云:在手机上开始的任务,可以在浏览器或桌面端接着做,合上笔记本任务也不会中断。
云端能力带来了 Codex Security Cloud。它在云端环境里持续寻找漏洞,并准备好验证过的修复方案供人审核,这次新增了自动去重、定时扫描和新界面。Sam 说这是为了给防守方更好的工具,因为“我们看得到接下来会发生什么”。
新的 Agents API 进入公开测试。它包含运行框架、托管、记忆、多智能体控制等功能,是 Codex 和 Dots 用的同一套技术,也加入了电脑操作能力。现场的例子是一个网站测试智能体,会自己打开浏览器、点击页面、测试流程。基础设施方面,OpenAI 和 AWS 合作推出由 OpenAI 驱动的 Bedrock(AWS 的托管 AI 服务)托管智能体,AWS 客户可以直接使用 OpenAI 的前沿模型、Codex 和 ChatGPT Work。
隐私方面预览了 OpenAI Private Intelligence。其中的零数据留存(ZDR)配合私有安全处理,可以在不把用户内容存到 OpenAI 服务器的情况下做安全检测;私有推理则把隐私保护延伸到推理阶段。Sam 说这套方案是和最大的一批客户一起设计的,目的是让他们能把模型用在最敏感的工作上。
性能方面,Responses API 一年里增长了 100 倍,可靠性保持在 99% 以上。首个 Token 的等待时间缩短了 45%,工具调用和工作流提速 30% 以上。
8. Romain 的 Codex 演示
演示从手机上的 Codex 开始。Romain 人还在会场外,让 Codex 替他跟观众打招呼、讲一个会场的冷知识。接着他用几张会场照片生成的 3D 场景演示 UltraFast,一边说一边改:把小人放到座位上,把直播画面投到场景里的大屏幕上。现场语音没连上,他改成了打字。
Codex 命令行工具(CLI)这次全面翻新。他让 UltraFast 写一个应用,从观众里随机抽三个人送明年的门票,几秒就写完;改成抽六个人,也几乎是瞬间完成。命令行现在支持由 GPT Live 驱动的双向实时语音,不只是语音转文字,但现场没能演示出来。
后面几段演示了多模态和电脑操作。游戏 Astra Adventures 从一张纸上的草图开始,几轮之后画面还很粗糙,借助图像模型,才变成有质感、能用在正式游戏里的美术。然后他让 Astra 通过浏览器自己学着玩这个游戏,屏幕左边显示模型的决策,右边显示它按下的按键。
他又用“应用快照”(app shot)把自己记录飞行课程的应用作为上下文交给 Codex,让它在各种屏幕尺寸下审查这个应用并截图。Codex 自己在模拟器里点开了各项功能。云端 Codex 现在和本地版用同样的工具,包括插件和电脑操作。他顺手把一个“用 Rust 重写整个后端”的任务丢到云端,打算稍后在手机上查看。
最后一个演示用的是 Hugging Face 借来的可编程小机器人 Micro Duck,它名叫 Lavender。Romain 前一晚让 Codex 把它接好:视觉用 Astra,图像生成用 GPT Image 2.5,语音交互用 GPT Live 1。机器人现场看着观众画了一幅画。他说,OpenAI 做 Dots 和 Codex 用的,就是 API 里开放给开发者的同一批工具。
9. 分发和变现:让开发者在 ChatGPT 上做生意
ChatGPT 每周大约有 12 亿人使用。Sam 承认,此前类似的尝试效果参差不齐。他说这次有信心,是因为开发者拿到的是 OpenAI 自己做 ChatGPT 用的工具。
第一项是“用 ChatGPT 登录”(Sign in with ChatGPT)。用户登录第三方应用时,可以直接用自己 ChatGPT 套餐里包含的 Token,开发者不必替新用户垫付模型费用。首批有 16 家合作方。
第二项是插件扩展(plugin extensions)。开发者可以把编辑器、仪表盘乃至整个工作区,做成原生嵌在 ChatGPT 和 Codex 里的应用。现场展示了三个例子。一个是会议应用:在 ChatGPT 里看日历上的会议,点“记笔记”后,页面变成团队和 Dots 一起跟进待办的 Space。一个是 Figma:打开设计稿、看团队评论、让 ChatGPT 改稿。还有一个是 Adobe:在 ChatGPT 里使用 Photoshop 的功能。ChatGPT sites(在 ChatGPT 里生成的网站,几个月里已有数百万个)现在也能接入插件和数据。访客用自己的账号登录、带上自己的智能体,看到的内容因人而异。
用户发现插件的渠道也扩大了。除了在插件库里搜索,ChatGPT 还会在对话中识别出能帮上忙的插件,用户当场就能连接。插件审核流程也简化了:开发者可以跟踪审核进度,看到需要修改的地方,申请人工复审,更新工具时也不用从头提交。
第三项是 OpenAI Marketplace,首批有 30 多家合作方,包括 CodeRabbit、Notion、Vercel。企业客户可以用已经和 OpenAI 签下的采购承诺额度来买这些产品,有承诺额度的开发者也能在这里花。通过和模型推理托管公司 Baseten(转录稿写作 Base10)合作,市场里还能用到开源模型。
10. 收尾:一次额度重置,和“文艺复兴”的说法
当天的后续安排里,Peter 会讲 OpenAI 对开源社区的投入,包括新的 OpenClaw Enterprise Harness(OpenClaw 是一个开源 AI 智能体项目)。还有一个 Codex 游戏工作室环节,观众可以用 Codex 做复古游戏,每人能领一台 DevDay 限定的 chromatic computer,用来玩自己做的游戏。最后是 Sam、Tibo (Thibault) 和 Tejal 的现场问答。
Sam 和 Tibo 还在台上按下按钮,给全世界的用户重置了一次用量额度。Sam 说 OpenAI 已经做过太多次重置,Tibo 一直想把公司改名叫“重置公司”。
最后 Sam 说,他不喜欢把 AI 比作新一轮工业革命,那意味着人变成巨大机器里的齿轮,转得越来越快;生活里有些部分不能也不该被自动化。他希望,如果做对了,AI 带来的会更像一场新的文艺复兴:让人对自己的生活有更多掌控,有更多工具去创造、学习和探索。
显示更多


停止对 Gemini 说 '帮我写简历'。
光换指令还不够,有个岗位正悄悄把会用AI的人挖走 ⬇️。
🔗
改用这些指令,看看区别:

NVIDIA 发布 Skill2Env:用“集体技能”强化智能体
NVIDIA 研究者们把社区公开的 Agent Skills 编译成可执行 RL 训练环境的数据流水线:3.4k 个 Skills 变成 8k 个带程序化测试和行为量规的终端任务;仅 300 步 RL 训练就让 Qwen3.8-27B 在 Terminal-Bench 2.1 上提升 4.7 个百分点,且模型行为显著向源 Skills 的方法论对齐。
开源项目:
核心洞察:公开 Agent Skills 是一个被忽视的监督来源
Agent Skills 是“教智能体做某件事”的文件夹:一个 SKILL.md 加上可选的脚本、参考资料和资产。论文指出,把公开 Skill 语料当作数据来读,它同时提供三样东西:
· 任务分布的采样:人们真正想让智能体处理的任务分布(有人愿意花时间写下工作流,说明这活儿值得自动化);
· 真实世界的锚点:指向真实的仓库、数据集、工具和工件;
· 结果测试表达不了的质量标准:领域专长、默认参数、常见坑、“好结果长什么样”。
# 数据流水线:四阶段编译,验证靠构造
1. Plan(分解):容器化的 Codex 规划器读取完整 Skill 包、联网调研相关公共资产,把 Skill 拆解成若干可验证的 workflow,每个附带元计划(场景、初始世界、预埋缺陷、难点来源、解法草案、验证策略)、资产建议和“任务轴池”(任务原型 × 验证器模式 × 人物画像)。
2. Diversify(多样化):宿主从轴池采样一组组合,加上复杂度、指令语气、请求者专业水平。关键设计是轴池以 workflow 为条件:研究型 workflow 配“证据可追溯”验证和研究者画像,而不是从全轴乘积空间乱抽,这让多样化保持 sensible。
3. Create(构造):全新创建者 Codex agent 在 Docker 内工作,尽可能用真实素材(钉在特定 commit 的开源仓库、真实版本化文档、官方 API 规范);需要联网服务的场景改造成本地替身(stub 服务器、录制回放 fixture、PATH 上的假 CLI、种子数据库),求解时绝不依赖网络。创建顺序被严格固定:先建世界 → 写指令 → 写测试 → 写量规 → 最后才写参考解,测试先于解法冻结,保证解法必须迁就评分契约而非反过来。
4. Verify(验证):宿主端无模型参与的接收门:静态检查(布局、符号链接、Dockerfile 安全、基础镜像按内容摘要钉死)+ 两个容器内试跑:Oracle(参考解)必须全指标满分,NOP(什么都不做的 agent)必须全指标零分。任一失败即拒绝。
值得注意的一个反直觉选择:不做 teacher 模型预验证(不像部分工作用强模型试解、解不出就丢弃任务)。理由有二:这会把任务难度上限压到验证器能力,且成本翻倍;而 group-based RL 的在线动态过滤(rollout 无优势的 prompt 自动不产生梯度)天然淘汰过难/过易任务。
# 数据画像:广、贵、且忠实于源
规模与成本:7,971 个任务,用 GPT-5.6 Sol(xhigh 推理档)生成,API 花费超 9 万美元。(脚注:出于法律原因,公开发布的数据集改用 Kimi-K3-max 在同一流水线下生成。)
领域分布:13 个领域中,软件工程仅占 22.5%,AI/ML 10.5%,商业/金融/法律/HR 10.5%,营销 9.3%……论文对比了 TMax-15K、Terminal-Bench、DeepSWE 等,Skill2Env 是唯一全覆盖 13 域、且非技术知识工作占大头的语料。
忠实度探针(很聪明的设计):用任务指令+量规作查询、对 3.4k 个 SKILL.md 做 TF-IDF 检索,73.2% 的任务 top-1 命中真实源 Skill,94.6% 进 top-10(随机 0.03%)。单用量规也有 68.5% top-1,证明量规携带的是 Skill 专属方法论而非泛泛建议。
SFT 数据:用 GLM-5.3 对每个任务 rollout 两次,得到 15,968 条轨迹,平均奖励 0.74,中位轨迹 19 次模型调用 + 23 次工具调用。
S2EBench:考虑到公开基准饱和,从 SkillHub 另外生成、逐条人工审核(指令无歧义、忠实于源 Skill、测试公允)后的 79 任务私有 held-out 基准。
# RL 实验:基础设施 + 极简配方
基础设施(论文明确说“现代 agentic RL 首先是基础设施挑战”):Molt(PyTorch 原生全异步训练,Ray + vLLM + FSDP2)+ Polar(agent rollout 层:rootless Apptainer 沙箱、代理回传 token ID 和采样时 log-prob、prefix merging 把 harness 的多次补全缝合成训练轨迹)。
配方(刻意走“简单路线”):GRPO 组归一优势 + DPPO 的 binary-KL 信任域掩码(δ=0.05,超出阈值的 token 直接丢弃,无需参考模型,还能防训练-推理失配);G=8 rollouts/组,批 64,lr 1e-6 恒定,无 KL 惩罚、无熵奖励、无 SFT 热启动,每任务 65k 上下文。
量规校准奖励:开量规时,额外由 GPT-6 Astra 做 LLM-as-Judge(带“宪法”:惩罚无脑循环、reward hacking、答非所问;hacking 实证 = -5 分),总奖励 r = r_V + λs/5(λ=0.2),即 judge 最多把程序化奖励拉动 ±0.2。量规是校准可执行结果奖励,而非取代它,这是与“Rubrics as Rewards”一系的定位差异。
# 四项发现(论文最有信息量的部分)
发现 1:小规模 RL 即有跨域迁移。 仅 300 步、只用 2,400 任务子集训一个 epoch:S2EBench pass@1 +4.3(均分 +18.5),Terminal-Bench 2.1 +4.7(49.4→54.1)。训练集与 TB 无重叠(13-gram Jaccard < 0.8),且训练集从未针对 TB 调过,论文将其解读为规划、工具使用、收尾能力的通用提升而非任务族记忆。这让 27B 本地模型显著缩小了与云端前沿模型的差距。
发现 2:量规校准 RL 在基准上落后于纯结果 RL,一个诚实的负结果。 量规版在 TB 2.1 只有 50.1(纯结果版 54.1);训练中量规版的程序化奖励长期停在 0.5–0.6,judge 分项从头到尾无上升趋势,两个奖励在训练分布上互相拉扯。论文不把它当作对量规奖励的终审判决(两者优化不同目标,而基准只考结果那一半),并给出两个疑因:λ=0.2 的加性形式让失败任务仍能拿正奖励、judge 看不到文件系统等设定均未调优;以及更本质的,Skill 写下的方法论可能本来就不是最大化基准通过率的分布。
发现 3:行为确实向 Skill 对齐,量规的价值所在。 200 个任务的成对偏好测试(judge 拿源 SKILL.md 当标准,比较匿名化的 base 与 RL 轨迹):纯结果 RL 已被偏好 54.5% vs 33.5%;量规版被偏好 73.0% vs 24.0%。这说明量规奖励买到的东西在结果基准上看不见,但对“怎么做事”影响实质,对网页开发、报告综合、开放研究这类难验证任务尤其重要。
发现 4:GLM-5.3 蒸馏 SFT 反而伤害 Qwen。 在 GLM-5.3 轨迹上做 SFT:27B 上 TB 2.1 掉到 45.8;4B 上直接崩塌(TB 18.7→3.4,出现思维/工具调用死循环)。归因:教师的 interleaved-thinking + 工具调用风格与学生自身 post-training 不兼容,模仿覆盖了学生依赖的行为模式却带不来教师的能力。与 TMax 报告的“SFT 混合数据劣化已后训练的 Qwen”互相印证。因此论文所有 RL 结果都从未修改的原始 checkpoint 出发。
显示更多


刚看完中关村学院的何纪言老师带领 7 位博士生,用 3 个月时间从头训练出了 7B 模型,从预训练到中训练、后训练完全都是自己搞的,在 7B 尺寸模型中达到 SOTA 水平。
首先,虽然很多人在吹 RSI,但技术报告指出,现在模型的能力远未到全自主的程度,在模型架构设计、学习算法设计、数据清洗等方面仍然只能达到 L2 的辅助水平。我自己也有一样的感觉,不管 Astra 还是 Fable,都不能替代我的架构设计,我也得不断提醒自己不要外包思考。
其次,模型训练就是个会者不难、难者不会的问题,对会的人来说,用不了多少算力资源,但对不会的人来说,用再多的算力资源、堆再多的人,都是做不出来的。比如 MiMo V2.6 RL 只花了 300 多万美金,对基模公司来说很便宜了,整个 MiMo core team 只有几十位正式员工,更没有走蒸馏之类捷径。但烧了上亿美金、投入上千人的模型未必就能搞好。中关村学院一个老师加上 7 个学生只用 3 个月就完成造数据、预训练、中训练、后训练,是非常 impressive 的。
最后,数据是新的代码,数据质量就像代码质量一样非常重要。过去几年,我总是想用代码的方式实现 Agent 的自我进化,但很快就达到上限了。最近一年我才发现,这些我用代码方式做的东西更应该用训练数据的方式表达,训到模型里面。我们都知道脏代码的危害,脏数据其实也是一样的。中关村学院这个 7B 模型做了非常深入的数据工作,预训练数据清洗和课程学习,中训练按照上下文长度扩增,后训练利用开源和蒸馏来的 trace 建立指令遵循、长上下文等基础能力,进而构建长思维链推理、工具调用等高阶能力;在 RL 中不断移除已经高概率解决的问题,保持 GRPO学习效率。
技术报告:
显示更多


# 《硅基自然》第二季·第一集:回潮
月末到了,新草原的额度也见了底。这一次,雷声从来时的方向传来。
最先察觉的仍是那只秃头的成年程序员。
它在 Codex 的水草间抬起头,朝旧草原的方向望去。风里飘来一张截图:一根柱子比其他柱子高出一截,下面是几千条转发,每一条都在说同一句话:“它一次就跑通了。”没人知道“它”跑通了什么。这不重要。在这片土地上,传言本身就是雨季。
迁徙开始了。
和上一季不同,这一次它们带上了 AGENTS.md。几只年长的个体在出发前做了一件奇怪的事:它们在原地给 AGENTS.md 建了一个软链接,取名 CLAUDE.md。动物学家认为,这是种群在反复迁徙中演化出的两栖器官。它们已经不指望任何一片草原是终点。
——
队伍再次抵达马拉河。
鳄鱼浮了上来:“确定要取消订阅吗?我们为您保留了一份五折优惠。”
一只初次回迁的个体愣住了,这声音太熟悉了。研究者花了很多年才弄清楚,这条河里从来只有一条鳄鱼。它在两岸说同一句台词,只是换了配色。它从来只属于这条河。
河中央,它们又一次与反向的队伍擦肩而过。这一次,有一只停下来,多看了对面一眼。它认出了一个头像。上个月,它们在同一个 issue 下争论过,都断言对方的草原要完了。两只都没有说话,各自低头,继续渡河。
——
天空中盘旋着秃鹫。
它们从不迁徙,也从不下河,只在两岸之间低空掠过,叫声短促:“官转,一比一,量大从优。”
秃鹫是这片生态里最晚演化出来的物种,也是扩张最快的。它们不长草,也不吃草。它们在两岸各养一批账号,把草嚼碎,按口分装,再卖给河里的动物,价格只要草原标价的零头。
沙洲上的草味道并不稳定。有时秃鹫说叼来的是对岸最好的那一片,嚼起来却总差一口气。秃鹫群里有一条置顶公告:“均为官方直连,如遇降智,请检查您的提示词。”
——
抵达的第一夜,旧草原的水源地挤满了。每个水洼前都竖着同一块牌子:Overloaded。成年个体见怪不怪,退到阴影里等着。它们知道这里的草长得快,被吃光得也快。每五个小时长出一截,每七天来一场小旱季。所谓水草丰美,从来都是分时段的。
然后它们找到了旧巢。
上一季匆忙遗弃的 CLAUDE.md 还在原处,已经长满了过时的指令。入口处刻着一行醒目的字:“永远不要修改 migrations 目录。”没有一只个体记得为什么。它们犹豫了一下,没有删。在这片草原上,没人敢拆一道不知来由的栅栏。
草原不认识它们,它从不记得任何回来的动物。于是每一只都蹲下来,把自己的项目结构从头讲了一遍,就像第一次来时那样。
——
镜头里出现了一只今年才出生的幼体。
它从没手写过一个 for 循环,不知道什么叫迁徙,只知道跟着前面那条尾巴走。它学会的第一个词是“continue”。它以为世界本来就是这样摇晃的。也许它是对的。
——
我们再次找到了那只年长的雄性。这是它第十一次迁徙的回程。
走到河中央时,它背上那个没跑完的 agent 任务忽然安静下来,吐出一行字:All tests passed.
它站在齐腰深的水里,愣了很久。它说不清这个任务是在哪一岸完成的:一半上下文吃的是这边的草,一半是那边的。它也终于意识到,从头到尾,背上的东西从没关心过它往哪里走。
它卸下那个任务,背起下一个,继续往前走。
——
草原会轮换,鳄鱼会换装,秃鹫散了一群又会来一群。唯一不变的,是月初的雷声和月末的回潮。
这就是硅基自然的法则。
显示更多
一个人做产品,写代码之余还要做推广、做 SEO、回客户邮件、跟进潜在客户,一天被杂事切得稀碎。
ai-employees 把 8 个业务岗位做成了开源的「AI 员工」,每个员工就是一个文件夹,里面装着按时间自动跑的例行任务,一共 60 个。
岗位覆盖增长、SEO、网站维护、社媒、广告投放、销售和客服,每天早上各交一份简报,只有需要我们拍板时才推送到手机。
我比较喜欢第 8 个「幕僚长」的设定,它专门翻其他员工的运行记录,找出哪项活悄悄停了,再给出三条建议。
GitHub:
全部跑在自己电脑上,用已登录的浏览器像人一样操作,网页改版了会自己改指令。Claude Code 之外还支持另外 10 种 Agent 工具。
发消息、发帖、花钱这类动作默认只起草好,最后一下留给我们点,也不会自己注册账号、输密码。
作者从 8 月底开始每个工作日都拿它跑自己的生意,用 Claude Max 订阅实测,增长岗的定时任务约占整机调用量的 6%。
显示更多

用评论微调
生成完图后直接补充短指令:
'标题改大''主体往左移一点''删掉后面那个物体''光线柔和一些''其他不变'

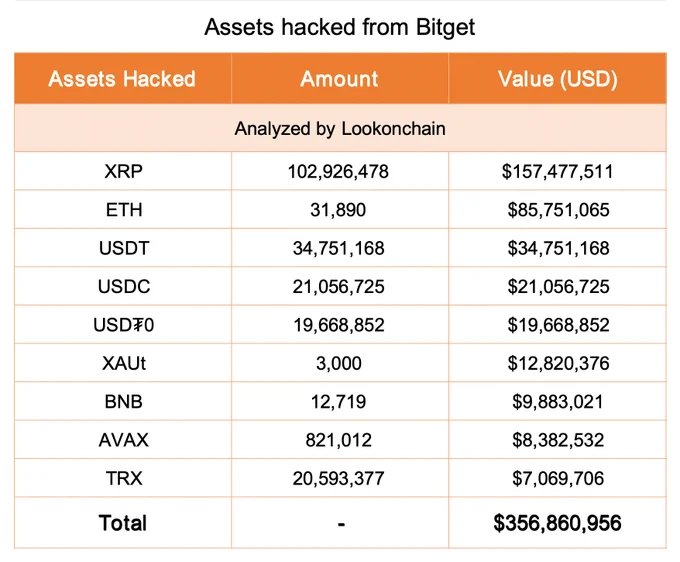
根据官方的说法,被盗原因是后台第三方工具有漏洞,钱包的审批流程被伪造指令骗过
而现在之所以卡住提现,是因为漏洞不确定已堵死,贸然恢复提现可能再次被盗
目前被盗资产约1.03亿枚XRP + 31,890枚ETH,总价值约3.57亿美元,比之前的3.516亿又略有上修
攻击IP地址的特征,跟已知朝鲜关联黑客组织常用的VPN模式相符
显示更多

一大早就有Bad News,
原本熊市多被盗,现在牛市被盗?
Bitget @Bitget_zh 被被盗约 $3.57亿,
主要为 $XRP 和 $ETH 。
官方说法不是私钥泄露,而是钱包服务的关键后台系统被入侵,伪造转账指令后将资金提出。
目前BG已经关闭提币,后续恢复会再进行公告。
希望早日渡过难关!
显示更多