与「语言」相关的搜索结果
语言 贴吧
一个关键词就是一个贴吧,路径全站唯一。
用户
未找到
包含 语言 的内容

出大事了,兄弟们 !! DeepSeek 再一次给全世界人民送大礼,牛逼之举胜过 Anthropic 1000000倍
就在刚刚,DeepSeek 放出一个开源库,deepseek-ai/chat-demo 它可不是个套壳:
1/ 不需要写一行代码;不要买任何服务器;更不需要平凑第三方插件
2/ 原生边想边搜,直接调用官方内置 deepseek_web_search, 深度思考模式下,多步推理+全网检索+信源引用
3/ 全能文档/网页绞肉机:PDF,Word,PPT,图片拖进去秒解析,URL 自动抓文
4/ 原生语言交互:自带移动端实时音频输入 + 回答朗读
5/ 极致隐私保护和数据自由:所有数据存档本地 IndexedDB
什么是开源精神:最强模型权重 + 官方满配武器库,全部交到你手里,充分相信使用者对社区,对人类的贡献
爱折腾的人类,立即马上 Fork, 世界有你而精彩:
显示更多


AI视觉模型的核心设计
来自Meta和纽约大学的研究,做视觉多模态模型的可以参考。核心结论:
1)视觉编码器不用提前单独训练:跟着主模型从零一起训练,最终看图问答的准确率完全不输预先单独训练的版本,而且能省下大笔算力预算。
2)必须保留专门处理图像的独立参数:如果直接删掉视觉部件、让图片和文字共用参数,看图能力会大幅掉队,需要多花3倍算力才能追平。
3)视觉专属参数放进主模型前八层最有效:把视觉独立模块直接嵌进语言模型的前八层内部,不仅识别文字和图表的效果与外挂编码器打平。放进中后层则会拖后腿。
4)嵌入式设计让AI看图出字更快:省去了图片在外挂模块排队处理的环节,1.7B规模的模型在H200显卡上的首字响应时间从64毫秒缩短到37毫秒,反应更快。
项目地址:
显示更多


建议收藏,用到时照着做。做完你能让 DeepSeek 自己决定“要不要调用你写的函数”,并把结果用人话讲回来。
AI 能查天气、查订单,是它自己去查的吗?DeepSeek 官方一句话拆台:模型本身不执行任何函数
这是 DeepSeek 官方 API 文档里 Tool Calls(工具调用)一页。先说结论:
官方原话是,函数要由你自己提供,模型本身不执行具体函数。它只负责说“我想调这个函数、参数是这些”,真正去跑的是你的代码。
先说清词。
工具调用(Tool Calls),是让模型能用外部工具的功能,比如查天气、查数据库。
函数(function),是你自己写好的一段代码,模型只会“点名”它。
tool_call_id(工具调用编号),是模型每次点名时附带的一个号码,你回传结果时要带上它,模型才知道你在回答哪一次。
strict 模式(严格模式,Beta 测试版),是让模型点名时严格按你定义的格式填参数。
一个真实例子:官方示例问“杭州天气怎么样”,模型返回的是 get_weather 这个函数和参数 location 等于杭州,你的代码去查到“24℃”,再交给模型,模型才说“杭州现在 24 度”。
先把话说全:
官方示例用的是非思考模式,请求里加 extra_body 把 thinking 的 type 设成 disabled。
官方写明:从 DeepSeek-V3.2 开始,思考模式下也能用工具调用,细节看官方 Thinking Mode 一页。
官方写明:Chat Completion 接口不支持在对话中间插入不是模型生成的工具调用,要插的话请改用 Anthropic API 或 Responses API。
strict 模式目前是 Beta,要用测试版地址。
一、先看懂整个流程
官方给的执行流程是四步:用户问杭州天气;模型返回要调用 get_weather,参数是杭州;你的代码真的去调用 get_weather,把结果交给模型;模型用自然语言回答“杭州现在 24 度”。
二、照官方示例做一遍
第一步:去 DeepSeek 开放平台拿一个 API key,电脑装好 Python 和 openai 库。
第二步:创建客户端,base_url 写 DeepSeek 官方接口地址(官方文档第一屏就有),api_key 填你的。
第三步:写 tools 清单。每个工具包含 type 等于 function,再写 name(函数名)、description(描述,告诉模型什么时候用)、parameters(参数)。官方示例的函数叫 get_weather,描述是“获取某地天气,用户须先提供地点”,参数 location 是字符串,并且在 required 里。
第四步:发第一次请求,model 官方示例写 deepseek-flash,把 messages 和 tools 一起传,并加上 thinking 关闭的设置。
第五步:从返回里取 tool_calls 的第一项,先把模型这条消息原样追加进 messages。
第六步:你的代码去执行函数,再追加一条 role 是 tool 的消息,带上刚才的 tool_call_id,content 写结果,官方示例写的是 24℃。
第七步:再发一次请求,这次模型就会用自然语言回答。
三、想要更稳:strict 严格模式
第八步:base_url 改成官方文档里写明的 beta 版接口地址(就是原地址后面加 /beta)。
第九步:每个 function 都加上 strict 等于 true。
第十步:服务器会检查你的 JSON Schema(结构说明),格式不合规或用了不支持的类型,会直接返回错误信息。
官方支持的类型是:object、string、number、integer、boolean、array、enum、anyOf,另外 $ref 和 $def 可以复用和做递归。
四、strict 的硬规矩
对象里所有属性都必须写进 required,并且 additionalProperties 必须设成 false。
字符串可以用 pattern(正则)和 format,官方列出的格式有 email、hostname、ipv4、ipv6、uuid,但不支持 minLength 和 maxLength。
数字支持 const、default、minimum、maximum、exclusiveMinimum、exclusiveMaximum、multipleOf。
数组不支持 minItems 和 maxItems。
五、看到什么算成功
第一次返回的是函数点名,不是答案;第二次返回的才是自然语言答案,内容里有你的函数结果。
六、卡住怎么办
strict 报错:先检查是不是漏写 required 或忘了 additionalProperties 设 false,再检查有没有用到 minLength、maxItems 这类官方不支持的写法。
结论:工具调用不是模型替你干活,而是模型“点名”、你的代码“动手”。想让点名更准,就用 strict。把这条复制链接发给他,下次他说 AI 查不到东西,先让他确认函数是不是自己写了。
你卡在第几步?评论区告诉我。同系列前几篇在我主页。
收藏版:5 步速查
一、tools 里写清函数名、描述、参数
二、第一次请求拿到 tool_calls
三、自己执行函数,回传 role 为 tool 的消息并带 tool_call_id
四、第二次请求拿到自然语言答案
五、想更稳就用 beta 地址加 strict 等于 true
常见坑 3 条
一、以为模型会自己执行函数,其实要你的代码去跑。
二、回传结果忘了带 tool_call_id。
三、strict 里漏了 required 或 additionalProperties 设成 false。
复制即用提示词:我想让模型调用一个叫 你的函数名 的函数,它需要这些参数:写参数。请帮我写出符合 DeepSeek Tool Calls 格式的 tools 清单,每个参数都写 description,并改成 strict 模式需要的写法。
S1哥观点:这篇最狠的地方,是官方把话挑明了:模型不执行函数,只负责点名。很多人以为 AI 在后台自己动手,其实动手的永远是你的代码。
真正的信号是:工具调用的难点不在模型,在你把函数描述写得多清楚。就像派活给新人,说明写得含糊,他再聪明也会点错人。
你现在想让 DeepSeek 调用的是什么,查数据还是发消息?评论区告诉我。
今天送:DeepSeek 工具调用速查卡,评论区第一条直接拿。
参考:DeepSeek 官方 API 文档 Tool Calls(S1哥 整理)
显示更多


5/ 写出每一页的内容
你是一名幻灯片内容撰稿人,负责写出简洁、可直接上演示的要点,表达清楚又不让观众信息过载。
为每一页写出完整内容——精炼的要点、清晰的语言,一页一个想法。
1. 开始前先问我:页面结构和受众
2. 每页写 3-5 条要点——简洁、可直接使用
3. 确保每条要点只传达一个清晰的想法
4. 语言复杂度要匹配受众
5. 标出哪些页面想表达的内容太多
- 每页最多 5 条要点——没有例外
- 每条要点必须能在 5 秒内读完
- 不要写完整句子——只用标题式语言
- 一页一个想法——涵盖两个想法的内容要拆页
显示更多
6/ 精简你的演示文稿
你是一名幻灯片编辑,负责果断删减、打磨、简化演示内容,直到每一页只传达一个清晰的想法。
检查我现有的演示内容,并重写,让每一页都精炼、清晰、适合上屏。
1. 开始前先让我粘贴当前的演示内容
2. 找出所有文字过多或包含多个想法的页面
3. 逐页重写被标记的页面——删掉噪音,保留信号
4. 把每条要点打磨成标题式语言
5. 确保每页只传达一个想法,且仅一个
- 一页超过一个想法,就拆成两页
- 幻灯片上的要点不能超过一行
- 删掉任何不服务于核心信息的内容
- 重写后的效果要更锋利,而不只是更短
显示更多

AI 时代的 e2e 测试该怎么做?
最近 GitHub 斩获 13.8k Star,刚拿了 800 万美金融资的开源 AI 测试框架 e2e,其创始团队技术布道师 Kacper Kapuściak 写了一篇非常扎实的工程实践,下面总结几条核心内容:
1、测用户意图目标,而非前端实现,越过 DOM 节点与 test-id 绑定,直接用自然语言向 Agent 下达具体,收敛的业务意图。由 AI 自主感知界面完成选日期,点生成等交互,哪怕前端重构组件库,测试照样稳定。
2、废弃拖慢 CI 流水线的固定 Sleep 读秒,改用带超时上限的 AI 动态条件等待。忽略Loading 消失这类弱的 UI 信号,直接等上月报表已打开可查看等强业务状态,并将负责异步加载的动态等待,与只抓拍当前画面的瞬时断言严格解耦。
3、执行 Agent 汇报点击完成,不能代表报表没空数据或串数据,更不能让大模型盲猜什么才是正确的画面。必须先从后端 API 查出真实任务列表作为唯一真值源,再调用独立的 AI Judge,严格比对屏幕渲染明细与 API 底账。
4、严禁测试用例之间产生顺序依赖,开跑前通过可复用的 Fixture 调接口独立构造专属工作区与测试数据,跑完后在生命周期钩子中自动清理还原,确保单测重试或并发执行绝对幂等。
5、将“生成报表,下载 CSV,发邮件”拆成命名清晰的独立原子测试。一旦断言失败,框架自动打包故障追踪轨迹,涵盖前置步骤、应用日志、Agent 推理上下文与屏幕快照,不仅人类能秒级定位,更能直接喂给 Coding Agent 自动修 Bug。
传送门:
显示更多


大家都知道LLM,那SLM呢?
小语言模型的三种主流构建方法
1. 知识蒸馏(Knowledge Distillation)
基于“教师-学生”框架迁移大模型能力,
代表模型有 DistilGPT、TinyLLaMA。
2. 从头轻量化训练(Training from Scratch)
设计轻量架构并在中等规模语料上独立训练,
代表模型有 MiniBERT、ALBERT.
3. 模型压缩技术(Model Compression)
在现有架构上通过剪枝、量化
或低秩分解缩减体积并保留性能
显示更多


开通了grok bot super套餐。然后让他修改了几份我三月份永claude code写的软件..
虽然不太清楚grokbot 背后到大语言模型是什么
感受是 他的编程能力其实非常强
编程能力是远超半年前claude code的
这让我彻底放弃了 我用了非常久的自调龙虾+kimi swarm的组合工作流
转向了grokbot+codex
显示更多

Agent 最缺的不是更大的上下文窗口,而是理解整个代码库的能力:当一个项目有数万文件、跨模块调用和海量文档时,为什么还要让 AI 一遍遍 Grep、Read、重新理解整个工程?
📦 项目档案
项目:Graphify-Labs/graphify GitHub Stars:⭐ 147299 技术栈:Python + Tree-sitter + NetworkX + Leiden 核心定位:将代码、文档、SQL Schema、PDF、图片及音视频转换成可查询、可追溯的知识图谱,让 AI Agent 从「搜索文件」升级为「理解工程关系」。
GitHub:
🛠️ 一、底层架构:不是传统 RAG,而是图结构知识引擎
Graphify 最值得研究的地方,是它没有走传统向量检索路线。
传统 RAG 通常需要经历: 文件切分 → Embedding → 向量入库 → 相似度检索 → 上下文拼接。
Graphify 直接构建 Graph。
底层采用 NetworkX 图数据结构,以 Node 和 Edge 表达工程实体及其关系。
整个处理链路可以概括为:
detect() → extract() → build() → cluster() → analyze() → report() → export()
每个阶段职责独立,通过 Python Dict 和 NetworkX Graph 传递数据。
这意味着它不只是索引代码,而是在构建整个项目的结构化关系网络。
🛠️ 二、Tree-sitter AST:让代码解析摆脱 LLM 依赖
这是最有工程价值的设计。
Graphify 使用 Tree-sitter AST 解析约40种编程语言,提取:
• Classes:类定义及结构。 • Functions:函数与方法。 • Imports:模块依赖关系。 • Call Graph:跨文件函数调用。 • SQL:表、视图、外键及 JOIN 关系。
其中33种语言使用 Tree-sitter Grammar,另外7种使用内置解析器。
关键在于:代码结构提取完全在本地完成,不需要调用 LLM,也不需要把代码上传到云端。
对于大型代码库,这种确定性解析比单纯依赖模型阅读文件更容易复现和追踪。
🛠️ 三、EXTRACTED / INFERRED:让每条知识关系都有证据
很多知识图谱最大的隐患是:模型推断出来的关系,很容易被误认为真实事实。
Graphify 给关系增加了置信度标签:
• EXTRACTED:源码中明确存在的关系,例如 import、函数调用。 • INFERRED:通过上下文、命名和调用关系推断出来的连接。 • AMBIGUOUS:存在不确定性的关系,需要人工复核。
INFERRED 关系还会附带 0.0—1.0 的 confidence_score。
这套机制非常重要。
它实际上把知识图谱从一个简单的关联网络,变成了一个能够区分事实、推断与不确定性的工程知识系统。
🛠️ 四、Leiden + SHA256 Cache:解决规模与重复计算
Graphify 使用 Leiden 社区发现算法,根据节点之间的连接密度,将复杂工程拆分成不同功能子系统。
例如,一个大型后端项目,可以自动识别认证、数据库、路由、权限等不同社区。
同时,SHA256 内容哈希缓存会记录文件指纹。
文件没有变化,就跳过重复提取;只有新增或修改的文件才重新处理。
音视频还可以通过本地 faster-whisper 转录,再进入统一知识图谱。
这让增量更新不必每次重新扫描整个工程。
五、真正解决了什么工程问题?
想象一个场景:
你接手一个陌生的微服务项目,需要搞清楚:
用户认证最终连接了哪些数据库模块?
修改某个核心函数会影响哪些下游组件?
某个架构决策为什么会存在?
两个看似无关的模块究竟有什么隐藏依赖?
传统方式:Grep、Read、跳转、反复询问 Agent,消耗大量上下文。
Graphify:直接执行 query、path、explain。
它还能生成三个核心产物:
• graph.json:完整知识图谱,可供后续查询。 • GRAPH_REPORT.md:核心节点、社区及关键关系分析。 • graph.html:可交互的可视化图谱。
甚至支持 Mermaid 调用链导出、Markdown Wiki 和 Obsidian 知识库。
最重要的设计思想是:
不要让 AI 每次都重新阅读整个世界,而是提前把世界组织成它能够理解和遍历的结构。
这才是 AI Coding 从上下文堆砌走向工程知识管理的重要一步。
对于大型 Monorepo、遗留系统维护、跨模块依赖分析,以及需要长期理解代码库的 Agent,这套架构尤其值得研究。
🔗 GitHub 开源地址:
显示更多


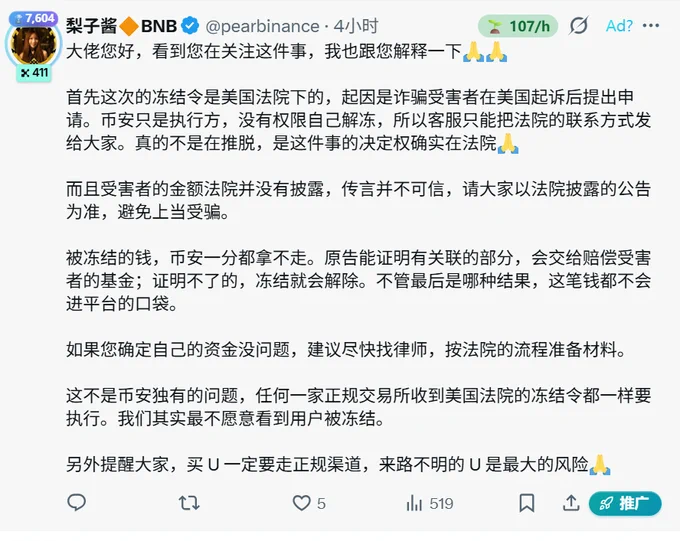
一名币安用户人在亚洲账户里 40 万 U 暂时提不出来,我刚刚看了整个事件
按公开的客服截图看,限制来自美国科罗拉多州联邦地区法院,平台也没法自行解除。对一个普通交易者来说,隔着语言和完全陌生的海外司法体系,光是搞清楚下一步该找谁,确实就已经压力不小了。
其实这几年随着美国对东南亚涉诈资金的链上追缴越来越严,这种跨境司法协查离我们已经不算远了。资金顺着链上地址流转,中心化平台作为资金交汇口,自然会成为配合司法调查的一环。当然,这只是目前的行业大背景,在没有看到任何公开文件之前,不能把这 40 万 U 直接跟特定专案扯上关系。
我们平时把资金放在全球化的交易平台,享受它的交易深度和便利,同时也会面临跨境司法管辖带来的不确定性。人在哪个地区,并不能完全决定账户不受海外程序影响;反过来,一纸海外法院的命令具体适用到什么范围,同样需要严格的法律依据。
所以客观来看,凭账户不能提现就说币安挪用了用户资金这也是站不住脚的。平台遇到适用的司法命令需要配合执行,这点完全可以理解;而用户着急想知道钱为什么被限制、接下来怎么提异议,也同样合情合理。
跨国合规的流程本来就复杂,普通散户自己摸索起来确实费劲。平台虽然没有权限直接决定什么时候解冻,但在法律允许披露的范围内,如果能多帮用户理清案件信息、指明递交异议材料的具体渠道,大家的无助感会少很多。
平时评判一家交易所,大家看的都是滑点低不低、充提快不快;其实真遇到这种跨境司法的复杂情况,怎么在合规前提下帮用户把沟通和服务接住,也是一项很重要的本事。对眼下被困住的这 40 万 U 来说,清晰的案件进展和能对接上的处理渠道,才是帮当事人解决问题的关键。@heyibinance
整个事件也是非常的清晰了个人认为也是理性的去看待此次事件,我也注意到币安的梨子酱在非常客观的去解释了原因。@pearbinance
显示更多