与「HBM」相关的搜索结果
HBM 贴吧
一个关键词就是一个贴吧,路径全站唯一。
用户
未找到
包含 HBM 的内容

网友:老黄走了,新法案落地了,从下个月开始,中国彻底没有海外的卡用了。所有的国模的训练都有可能会暂停,东南亚的百万卡的中国集群要彻底被切断了,无论是H100, H200+,还B200, B300+。当年华为为了一己之私,强行阻断了本来两国都已经批准的H200进口,拍着胸脯说自己能供给上,现在彻底被卡了。等华为明年能真正开始供给的时候,美国的AI在前方看不见的地方了。
老黄真是对中国最友好的CEO,过去几年用各种方法全力游说解除对中国的管制,并且对中国厂商的各种行为睁一只眼闭一只眼。各种沸腾还骂他,现在老黄也要下台了。你要知道,过去几年支撑中国大模型发展的,包括DeepSeek,支撑他们的其实是老黄,而不是华为。要不是老黄,根本就不会有国模的进展。
现在对中国最友好的老黄要下台了,之后怎么样?
华为的昇腾,单卡算力太低,即使有超节点,也很难训练大模。而且国内HBM+,良率极低,灰色通道进口的HBM数量极少,根本没法大规模供应。东南亚集群一旦断了,下一代大模型的路就会被堵死很长一段时间。
显示更多

微友:
老黄走了,新法案落地了,从下个月开始,中国彻底没有海外的卡用了。所有的国模的训练都有可能会暂停,东南亚的百万卡的中国集群要彻底被切断了,无论是H100, H200+,还B200, B300+。当年华为为了一己之私,强行阻断了本来两国都已经批准的H200进口,拍着胸脯说自己能供给上,现在彻底被卡了。等华为明年能真正开始供给的时候,美国的AI在前方看不见的地方了。
老黄真是对中国最友好的CEO,过去几年用各种方法全力游说解除对中国的管制,并且对中国厂商的各种行为睁一只眼闭一只眼。各种沸腾还骂他,现在老黄也要下台了。你要知道,过去几年支撑中国大模型发展的,包括DeepSeek,支撑他们的其实是老黄,而不是华为。要不是老黄,根本就不会有国模的进展。
现在对中国最友好的老黄要下台了,之后怎么样?
华为的昇腾,单卡算力太低,即使有超节点,也很难训练大模。而且国内HBM+,良率极低,灰色通道进口的HBM数量极少,根本没法大规模供应。东南亚集群一旦断了,下一代大模型的路就会被堵死很长一段时间。
显示更多

Everyone believes CUDA is NVIDIA's moat, the reason we've maintained our dominance in the AI era. I've never believed that.
NVIDIA has only one true moat: its people. And the most important of them is Jensen Huang.
I've worked on CUDA compilers, libraries, and DSLs for eight years, from Volta to Rubin. I think I've earned the right to share my perspective on what NVIDIA's moat really is. I hope you'll bear with me.
1. What is CUDA?
Many people think CUDA is just a programming language and its compiler, and that NVIDIA's moat comes from the massive amount of software written in CUDA, making it impossible for developers to leave NVIDIA GPUs.
This is completely wrong. It's an incredibly naive understanding of CUDA.
To me, CUDA is everything NVIDIA does.
CUDA isn't just a language, software, or hardware architecture. It's a product defined by a unique customer experience.
When you find GPU programming too difficult, CUDA gives you an easier way. When your GPU code isn't fast enough, NVIDIA engineers respond and help you solve it. When a handful of GPUs can no longer push your technology forward, NVIDIA has already scaled its computing platform from desktops to massive data centers. When you need more data centers than anyone else can supply, NVIDIA has already secured wafer and HBM capacity years in advance to meet your demand.
That experience is CUDA.
It's made possible by the relentless, day-to-day work of everyone at NVIDIA. And the person who brings all these people together, who gives them a shared vision and purpose, is Jensen Huang.
2. What made CUDA possible?
Patience. Perseverance. An unwavering commitment to a vision.
Around 2006, NVIDIA bet that the future would demand far more computing power, and began transforming GPUs from graphics processors into a platform for general-purpose computing. Initially, it was a commercial disaster. The added costs hurt margins, the market wasn't ready, and the strategy faced enormous skepticism and pressure, including questions from the board.
But Jensen persisted.
For roughly a decade, NVIDIA kept investing in CUDA, building its hardware, software, and developer ecosystem long before the commercial payoff became clear.
Eventually, deep learning arrived. And NVIDIA was ready.
Today, this sounds like an inspiring story. But for those who lived through it, it meant a decade of perseverance, doubt, and being misunderstood.
Looking back at the history of technology, how many people could have done the same?
This is what I've always loved most about NVIDIA.
And now, Jensen has been pushed out.
This won't kill NVIDIA. The company can still create tremendous commercial value. But it has killed NVIDIA's soul. And how far can a body go without its soul?
If this is how Jensen Huang is treated today, how will those of us who built CUDA be treated tomorrow?
I love NVIDIA deeply, but I have to say it: NVIDIA is dead.
显示更多

1/ AI 制药正在复刻半导体的“瓶颈交易”。
半导体的需求从 GPU 传导到 HBM、网络、电力和散热;生物医药则沿着:
AI模型 → 设计 → DNA/蛋白 → 检测 → 临床前产能
模型生成越来越便宜,真正稀缺的开始变成湿实验验证。👇
显示更多


AI Drug Discovery Is Becoming a Bottleneck Trade
I get excited when an industry starts going through a real regime change. AI drug discovery (“AIDD”) increasingly looks like one of those moments.
Two things are happening:
1/ Upstream: the frontier AI labs are piling in.
2/ Downstream: The supply chain is clearly moving.
Supply-chain checks suggest the upstream picks-and-shovels of discovery and early preclinical R&D are starting to feel the increase in experimental volume.
DNA → protein → assays → sequencing → automation → preclinical testing
Names across that stack include $TWST , @GenScript , $ILMN , $TXG , lab-automation vendors and CROs.
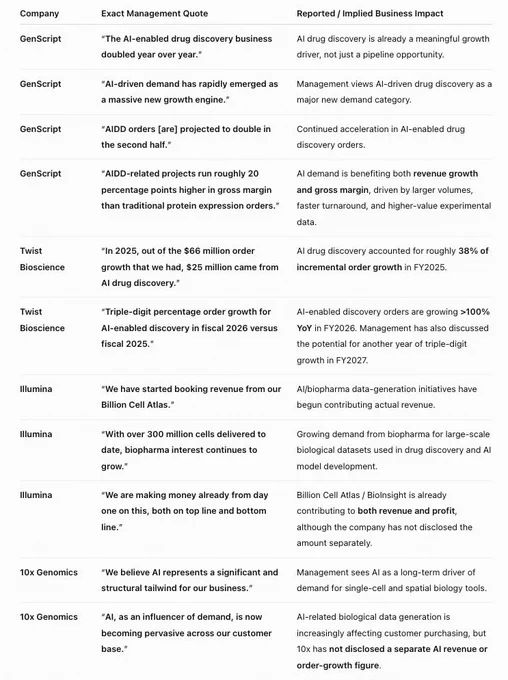
$TWST expects triple-digit percentage growth in AI-enabled drug-discovery orders in FY26, and another year of triple-digit order growth in FY27.
@GenScript's AIDD business doubled YoY in 1H26. Its current platform advertises industrial-scale validation of 4,000+ designs/day, with integrated sequence-to-data workflows. Our channel checks suggest the ramp is moving even faster: roughly 8,000 designs/day currently, with a path toward ~16,000/day by YE26.
---
Why does AI drive more wet-lab demand?
1/ AI makes hypothesis generation almost free → way more shots on goal.
The bottleneck is moving from expert-driven design to biological validation.
2/ AI models need continuous experimental feedback — and both good and bad data are useful.
Traditionally, only the highest-conviction A+ candidates might get pushed into expensive validation. With AI, even the B/C candidates can be valuable because failed experiments generate training data.
@GenScript has said its sequence-to-binding workflow can return data in 4–7 days, and that faster cycle times matter because AI models depend on continuous experimental feedback.
@Anthropic is a clean example. @claudeai designed 1,320 protein binders. @adaptyvbio converted those digital sequences into DNA, expressed the proteins and tested binding. Only 354 actually bound. And the 966 failures are not wasted. They are useful negative labels: what does not express, what does not bind, what has poor affinity. Those results help train the next model iteration.
3/ Wet labs are no longer just making drugs. They are making training data.
$TWST / @GenScript increasingly look like biological data foundries.
$TWST explicitly talks about generating model-ready data from AI-designed sequences. In some workflows, the customer may care less about receiving the physical protein than about getting structured experimental results back into the model.
Traditional drug discovery asks: “Does candidate X work?”
AI drug discovery also asks: “What can this experiment teach the model?”
---
TAM of AIDD
If AI is simply a better R&D tool, the relevant spending pool is the $300–400B of annual global pharma R&D. If AI meaningfully increases the number of viable drug programs, the opportunity is larger because it expands downstream demand for DNA synthesis, protein production, assays, and preclinical work.
Near term, we can also size demand from AI-company spending. If Anthropic reaches $80B of ARR in 2026 and spends just 1% on AIDD, that alone would imply ~$800M of annual investment.
---
Trade setup
This is a trade that could have long legs. It’s hard to really stop working until PhaseI/II results (2028+)
It smells a lot like the bottleneck trade we just saw in semis: GPUs → HBM → networking → power/cooling. In biology, It basically follows the drug discovery process downstream: AI models → designs → DNA/protein → assays → preclinical capacity.
After the upstream picks-and-shovels, animal testing could become the next bottleneck. Monkey prices are already near prior highs and CRO capacity is tight. AIDD pushing more candidates into preclinical development would only add demand.
?? But clinical trials are still the bottleneck?
This is the biggest pushback I keep coming back to. No matter how fast discovery becomes, drugs still need to go through preclinical → Phase I → Phase II → Phase III → approval. You still need patients, time and capital.
But that doesn’t mean the bottleneck trade won’t work. More viable candidates — especially with higher success rates — still means more demand throughout the development process.
And who knows: clinical trials themselves may eventually be optimized by AI.
?? What breaks the trade?
Near term, the picks-and-shovels trade breaks if experimental budgets stop growing, AI-generated designs don’t translate into useful wet-lab hits, or capacity catches up too quickly.
Longer term, the thesis breaks if AI drugs look great in discovery / Phase I but fail at normal rates in Phase II/III. That is why Phase II matters so much.
?? Milestones
Late 2026–2027: first Isomorphic-designed drugs enter human trials; more AI-native programs move into IND-enabling work / tox.
2028–2030: clinical trial results start telling us whether AI-designed drugs actually perform better than conventional drugs.
Calling all the "bottleneck bros". :) @jukan05 @zephyr_z9 @aleabitoreddit @ParadisLabs
+++
More comprehensive analysis:
显示更多


这个开源项目系统整理了 35 家 AI 公司的 AI 工程师面试题,全部来自 “公开报告的面试经历”
来自 @outcome_school 团队 @pallavishekhar_ 开源发布,内容几乎涵盖了 OpenAI、Anthropic、DeepMind、xAI、DeepSeek、Kimi、GLM 等 AI Labs,Cursor、Cognition、ElevenLabs 等 AI Native 团队和 Nvidia、Microsoft、Amazon、Apple 等头部大厂。
覆盖的岗位头衔也非常多:AI Engineer、LLM Engineer、Gen AI Engineer、ML Engineer、Research Engineer、Applied Scientist、FDE、MLOps/LLMOps 工程师等。
开源地址:
# 内容架构:一个精心设计的双层结构
第一层:跨公司通用题(Common Questions)。
作者把在多家公司反复出现的题目只列一次,标注"Asked at"哪些公司,按十大主题组织:
1. LLM 内部机制与架构 — attention 缩放因子、KV cache 内存公式推导、MQA/GQA/MLA、FlashAttention、BPE、RoPE/YaRN、Chinchilla scaling laws、MoE、解码采样策略、lost-in-the-middle、RMSNorm、SwiGLU
2. 推理、服务与 GPU 性能 — prefill vs decode、continuous batching、PagedAttention、投机解码、量化(FP16→FP4)、五种并行策略、TTFT/TPOT 指标、H100 上的 roofline 计算、vLLM/SGLang/TensorRT-LLM 选型、“如何把服务成本降 10 倍”
3. RAG 与检索 — 分块策略、BM25 vs 稠密检索、重排序器、HyDE、权限感知检索、ANN 索引、索引新鲜度、答案归因
4. Agent 与工具调用 — ReAct、MCP、工具 schema 设计、多智能体编排、Agent 记忆、循环终止条件、人类审批
5. 微调与对齐 — RLHF/DPO/GRPO/RLVR 全谱系、LoRA/QLoRA 数学、灾难性遗忘、“提示 vs RAG vs 微调”决策框架、蒸馏、reward hacking
6. 评估与可观测性 — LLM-as-judge 及其偏差、幻觉检测、基准污染、Agent 评估、回归门禁
7. 安全与负责任 AI — 提示注入(直接/间接)、OWASP LLM Top 10、护栏、Constitutional AI、红队
8. 多模态与语音 — VLM、语音 Agent 延迟预算、barge-in 打断处理、级联 vs 端到端语音、ASR/TTS 评估
9. AI 系统设计 — 十类高频设计题(千万级文档企业 RAG、代码助手、客服 Agent、Text-to-SQL、LLM 网关、数亿用户聊天服务等)
10. 编码题 — 从零实现 attention、KV cache、BPE、采样;LRU 缓存、令牌桶限流器、异步批处理器、SSE 流解析器、最小 Agent 循环
第二层:35 家公司的专属章节,分为五大梯队:
1. 前沿实验室(12 家):Anthropic、OpenAI、Google DeepMind、Meta、xAI、Mistral、Cohere、DeepSeek、月之暗面(Kimi)、智谱(GLM)、阿里(Qwen)、Sarvam AI(印度)
2. 大厂 AI 组织:Microsoft、Amazon、Apple、NVIDIA、Tesla,以及一组消费级 ML 公司(Uber/Netflix/LinkedIn/Airbnb/Pinterest/Spotify)
3. AI 基础设施公司:Databricks、Groq、Together AI、Hugging Face、Scale AI、Perplexity
4. AI 原生产品公司:Cursor、Cognition(Devin)、Sierra、Harvey(法律)、Glean、 AI(机器人)、Waymo
5. 前向部署/企业 AI:Palantir
# 题目分布透露的行业信号同样值得关注
1. 公司的差异化考察方向,和它的商业模式严丝合缝。 这是最能体现整理功力的地方:
· DeepSeek、月之暗面、智谱、Qwen 的题目深度绑定自家论文——MLA、auxiliary-loss-free 负载均衡、Multi-Token Prediction、MuonClip、DualPipe、长上下文扩展、GLM 的 thinking 模式。面试这些公司等于面试它们的论文,还要求 PyTorch 从零实现 MoE 路由。
· Groq 的题全是 SRAM-only 架构下的 roofline 重推演:“没有 HBM,decode 的 roofline 论证哪里变了”、“确定性在 p99 层面到底买到什么”。
· Apple 清一色端侧:3B 模型在手机上跑、PTQ vs QAT、不采集用户内容的前提下用设备信号改进模型、30+ 语言区无法记录用户内容的评估方案。
· CharacterAI 是推理经济学:“我们的服务成本被 KV cache 而非权重主导,降一个数量级,代价是什么”。
· Harvey(法律)和 Abridge(医疗) 考的是领域约束下的工程:200 页信贷协议里第 140 页的条款依赖第 8 页的定义术语怎么检索、生成的病历中出现了患者没提过的药怎么当作安全事故处理、PHI 如何约束整个架构。
· Palantir 的招牌是 "decomposition" 轮:把“一家货运铁路公司每年因机车非计划停机损失数千万”分解成工程计划。
2. 编码轮的形态正在发生实质性变化。 文档里反复出现的一类题,与传统 LeetCode 明显不同:
· “实现一个内存 KV 存储:先 SET/GET/DELETE,再加事务 BEGIN/COMMIT/ROLLBACK,包括嵌套事务”(OpenAI、xAI 都问)
· “给你一个 LLM 推理引擎的调度器类,其中一个方法是空壳,没有规格没有文档。说说你头三十分钟干什么”(xAI)
“重构这 120 行能跑但很乱的代码,不许破坏测试”(OpenAI)
· “对 5 万个文档跑 LLM 调用,API 限 100 并发、偶发 429 和超时,把 Python 写出来”(Anthropic)
考察重心从算法记忆转向增量需求下的代码演进能力、并发正确性、真实工程约束下的取舍。
3. “AI 协作轮”作为新题型已经进入正式面试流程。 这是文档里最前沿的信号:
· Anthropic 部分机器学习岗有 AI-collaboration 轮:现场给你 Claude,考察的是你如何指挥它和验证它的产出,而不是你自己写。
· Meta 2026 年的流程新增三阶段 AI 辅助编码轮(探索修复 → 实现新功能 → 扩展改进)。
· Cursor 的 onsite 是两天在真实 Cursor 代码库上做一个功能(或 8 小时远程版),明确考核你对 AI 工具的使用效率和自主 scoping 能力。
· Sierra 给你两小时和任意 AI 工具,看你选择做什么。
xAI 有四小时限时产品构建。
4. FDE 成为一级岗位类别。 Anthropic、OpenAI、Databricks、Scale、Together、Sierra、Harvey、ElevenLabs、Palantir 的章节里都有 "Applied and Forward-Deployed Scenarios" 专属题库——典型题目如“企业客户说 Claude 幻觉太多,你是驻场工程师,头 48 小时做什么”。这对应了 AI 公司向企业交付方式的转变:模型能力差距收窄后,落地能力成为差异化。
5. 硬核系统题的普及。 "H100 上 70B 模型 batch size 1 的 roofline 计算"、"估算 70B 模型的 GPU 显存(权重 + KV cache + 激活 + 碎片)"、"p99 延迟在部署后翻倍但模型没变,走一遍诊断”——这类题横跨 NVIDIA、Together、OpenAI、Perplexity 等多家,说明推理性能的量化直觉已成为 AI 工程师的通用素养,而非基础设施工程师的专属。
显示更多


高盛Rich Privorotsky:Muse只是起点,AI Agent真正要重写的是整个经济的“摩擦成本”
高盛One-Delta交易台负责人Rich Privorotsky现在关注的,已经不只是 $META 的Muse有多火。
他提出了一个更大的判断:
Agentic AI正在开始消除整个经济体系里长期存在的“摩擦”,而这可能带来一次真正的生产率跃升,并形成结构性的去通胀力量。
这可能也是理解下一阶段AI行情最重要的一条线。
过去三年的AI牛市,市场主要交易的是:
训练模型 → GPU → HBM → 数据中心 → 网络 → 电力
而下一阶段,市场开始交易一个完全不同的问题:
当AI真正进入日常经济活动以后,它到底能够替人类省掉多少时间、成本和中间环节?
Muse真正改变的,不只是AI能力,而是“消费者惯性”
很多行业过去能够长期维持较高利润,并不完全因为它们的产品无法替代。
其中一个很重要的原因,是消费者嫌麻烦。
保险续费涨价了,你懒得重新比较几十家公司。
手机套餐贵了,你懒得转运营商。
酒店价格高了,你没有时间每天重新搜索。
订阅服务每个月继续扣钱,你甚至已经忘记自己还在付费。
退款需要打电话、发邮件、等待客服,很多人最后干脆放弃。
这些看似微不足道的事情,实际上构成了一个巨大的隐形经济:
Consumer Inertia——消费者惯性。
过去消费者的时间有限,所以很多公司实际上可以从“麻烦”本身赚钱。
Muse这样的AI Agent正在攻击的,恰恰就是这种摩擦。
如果你的AI可以24小时替你比价、取消订阅、申请退款、重新谈账单、寻找更便宜的保险、比较酒店、订机票甚至完成支付,那么过去建立在消费者“不想折腾”之上的商业模式就可能受到压力。
AI最先消灭的,未必是某一个行业,而是“麻烦”本身。
为什么这可能带来结构性去通胀?
想象一下,当未来几亿甚至几十亿消费者都拥有一个永远不会累、永远愿意比较价格的AI Agent,会发生什么?
保险公司更难依赖客户懒得换公司维持高价格。
旅游平台必须证明自己的佣金真正创造价值。
长期不用的订阅可能被Agent自动取消。
零售商品的价格透明度进一步提高。
企业内部大量重复的行政、客服和后台流程也可能被自动化。
于是经济体系中大量长期存在的成本:
信息差 + 搜索成本 + 时间成本 + 人工成本 + 中间环节
都有可能被压缩。
这就是Privorotsky所说的生产率红利。
过去互联网降低的是信息传播成本。
移动互联网降低的是连接成本。
而Agentic AI下一步可能降低的是:
行动成本。
这可能比单纯推出一个更聪明的大模型,对整个经济的影响更加深远。
所以AI行情可能开始从“卖铲子”走向“生产率革命”
第一阶段的赢家其实非常容易理解。
$NVDA、$AMD、$TSM、$AVGO,以及HBM、网络、光通信、服务器、数据中心和电力基础设施。
因为无论最后哪一个AI模型胜出,都必须先购买算力。
但Agent时代真正有意思的地方,是AI创造的价值可能开始从基础设施向整个经济扩散。
企业可以减少后台人工成本。
客服效率提高。
营销变得更加精准。
库存管理改善。
软件开发周期缩短。
采购和供应链流程自动化。
消费者寻找商品和服务的成本下降。
当这些效率提升逐渐进入企业利润表以后,AI的赢家就不一定永远只集中在半导体。
第一阶段赚的是“建设AI”的钱。
第二阶段赚的可能是“使用AI提高生产率”的钱。
这两轮行情的受益公司可能完全不同。
CPU为什么突然成为Agentic AI的重要交易方向?
这一点也值得特别关注。
过去生成式AI最重要的硬件交易是GPU,因为训练和大规模模型推理高度依赖GPU。
但Agent并不是简单回答一个问题。
它需要打开浏览器、运行操作系统、调用API、处理文件、管理数据库、执行代码、安排任务,甚至同时运行多个Sub-Agent。
这意味着Agent时代增加的不只是模型推理负载。
它还增加了大量传统计算工作负载。
所以市场近期开始重新关注CPU以及整个服务器基础设施。
如果未来不是几百万人偶尔问AI一个问题,而是几亿个Agent每天在后台连续工作几个小时,那么计算需求的结构本身都会发生变化。
这也是为什么现在不能再简单用:
“AI = GPU”
来理解整个产业链。
未来更完整的公式可能是:
AI Agent = GPU + CPU + Memory + Storage + Networking + Power
Agent运行时间越长,需要调用的工具越多,整个数据中心被消耗的资源也就越多。
但市场现在仍然处于非常早期的定价阶段
目前指数很强,但市场宽度并不好。
大量资金依然高度集中在AI和少数大型科技公司。
所以现在看到的更像是三个阶段:
第一阶段:AI基础设施重新定价。
GPU、HBM、网络、数据中心、电力率先上涨。
第二阶段:Agent平台重新定价。
$META 的Muse只是最近最明显的案例之一。
第三阶段:整个经济的生产率重新定价。
如果Agent真正大规模进入企业和消费者生活,受益范围才可能从科技行业逐渐扩散到更广泛的权益市场。
而现在,我们可能刚刚站在第二阶段的入口。
这也是为什么高盛交易台对大盘仍然保持积极观察
Privorotsky的另一个核心观点是,目前市场并不是毫无风险。
季节性仍然存在。
实际利率仍然偏高。
地缘政治风险没有消失。
市场宽度也并不理想。
但另一方面,投资者对这些问题已经非常警惕,仓位和情绪本身并没有进入极端乐观状态。
因此他认为,市场仍存在进一步向上突破的空间。
这里真正值得注意的,不是简单地说“美股一定继续涨”。
而是:
如果Agentic AI开始被市场从一个科技产品故事,重新理解成一场生产率革命,那么它能够支撑的估值范围,就不一定只局限在几家AI芯片公司。
这可能才是下一轮行情真正值得观察的变化。
过去三年,我们一直在问:
谁能提供AI需要的算力?
接下来市场可能开始问:
谁能够利用AI,把自己的收入增长得更快、成本降得更低、利润率做得更高?
而再往后,还有一个更大的问题:
如果Muse只是第一批真正进入大众市场的Agent,当几十亿个AI Agent每天替人类工作、购物、谈价格、管理订阅和完成交易时,今天哪些行业看起来稳定的利润,其实只是建立在“人类嫌麻烦”这件事上?
显示更多

阿里平头哥发布真武V900 AI芯片,单卡216GB显存,片间互联来到1.2T,原生支持FP4、FP8精度,配套全新磐久超节点,预计2027年Q1正式上市。
回看三年前英伟达发布的H200:141GB HBM3e显存,片间互联900G。
国产这波参数纸面对标,看起来有机会赢麻了哈哈哈,就看实际落地表现!
显示更多


SK海力士终于突破关键压力位
HBM4放量预期叠加Q4潜在新一轮回购
市场开始重新交易它的利润和股东回报逻辑。
接下来最关键的,不是涨了多少,而是突破之后能不能站稳。
$SKHY
显示更多

8.28梭哈晨报:
别说太晚了,我tmd堵车刚到家,遛个弯堵了一上午,这是什么日子啊。
1. $BTC 震荡结束,继续开始单边上涨,全员梭哈做多?
2. $ETH 也在上升突破了,就看有人买单了没;
3. $SOL 已经开始突破100了,近期新高了;
4.Epoch AI:OpenAI 与 Anthropic 收入高速增长,合计年化达 1050 亿美元;
5.x402日交易笔数达210万笔,创下历史新高;
能不能拉盘下x402啊?
6.Thinking Machines 联合创始人 Barret Zoph 重返谷歌;
能拉股价吗?
7.美国法官裁定国防部将 Anthropic 列入黑名单属违法;
8.贝森特:过去14天美国已引导1.3亿桶石油通过霍尔木兹海峡,伊朗原油输出量为零;
9.ICO市场需求减弱,美国SEC拟重新向投资者开放公开代币销售;
正经人还会投资ico吗?
10.疑似a16z机构两天内已投入3,600万枚USDC买入44.1万枚HYPE并质押;
想到了自己当时被市场fud而割肉的HYPE;
11.Aave V4 存款突破 8 亿美元,单周涨幅达 30%;
所以拉盘不拉盘呢?
12.小摩:AI token 支出月增 7%、B200 租赁首降 1.5%、DRAM 现货连涨五个月;
所以还是缺CC?
13.Stripe与Advent决定放弃收购PayPal,此前报价超500亿美元;
好家伙换GME来收购吗?
14.SemiAnalysis:HBF 非 HBM 替代,成本与散热仍存不确定性;
15.迈威尔FY2028收入预期升至180亿美元,FY2029定制芯片指引成为下一关键;
------------
整个圈子都是孙哥的小作文了,已经弥漫到了国内的媒体平台了,没想到币圈距离娱乐圈这么近,也从侧面反馈出了,有的人不仅没饭吃还要帮忙教人洗内裤😂。
#Bitcoin# #Ethereum# #Solana# #Crypto# #Nasdaq#
显示更多
